
多芯插件机制与 SGLang-Kunlun 最佳实践
作者:xxinjiang2026.09.29 14:45浏览量:3简介:多芯插件机制与 SGLang-Kunlun 最佳实践
本文整理自 26 年 9 月 22 日 SGLang Meetup 北京站活动的同名主题演讲。项目地址:https://github.com/baidu-baige/sglang-kunlun。
在【百度智能云技术站】公众号回复「SGLang-Kunlun 2609」,可以获得此次 Meetup 上午的 3 个演讲主题材料。
各位嘉宾、各位社区的开发者,大家好。
这两年国产算力起得很快,做推理引擎的同学多半都遇到过同一个现实问题:SGLang 这么优秀的框架,怎么才能在一块架构完全不同于 GPU 的国产芯片上,同样跑得又快又稳?这正是我们过去一段时间全力在做的事。
我们的目标就一句话:让开发者在昆仑芯上用 SGLang,感觉就像在用最熟悉的 GPU 一样。
今天我想从三个部分和大家分享:SGLang 的多芯插件机制、我们在昆仑芯上的适配实践与性能优化,以及在 Agent 时代我们怎么让 AI 真正参与进来。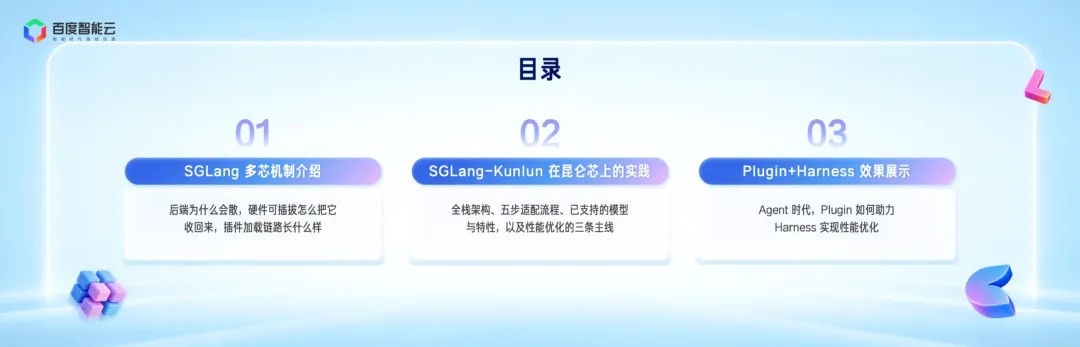
1. SGLang 多芯机制介绍
SGLang 社区现在已经上百万行代码。目前支持 CUDA、ROCm、NPU、XPU、MUSA 等多种硬件后端,社区还在不断接新的进来。听上去很繁荣,但后端一多,主仓就被拖得越来越重。
每加一种硬件,attention、KV pool、graph runner、量化、通信这些实现就散落主仓各处,改一处通用逻辑得照顾所有硬件,新功能想进来也越来越难。同时,要让一个后端持续可用,需要完整的持续集成覆盖率和维护者持续投入,社区很难为每个后端都提供这样的保障。结果就是,一个通用特性要落地得同时照顾所有硬件分支,改动成本被放大,门槛越来越高。
这也让主社区的开发者和 maintainer 很难受。不管是重构老功能还是开发新功能,都得先做一个选择:我要不要遍历主社区支持的所有后端,保证它们都能跑起来?对 NPU、XPU、MUSA 这些第三方社区的开发者来说,问题更大,跟不跟主社区的版本?主社区迭代太快,跟就得投入额外人力,不跟又怕进度落下。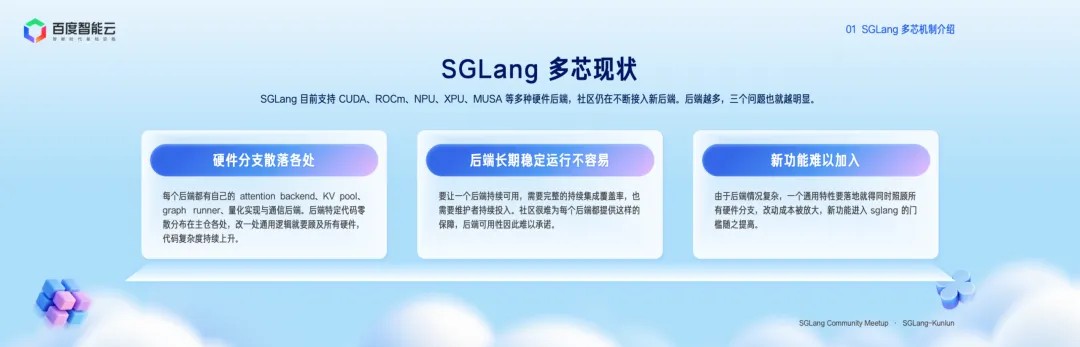
所以社区的解法是硬件可插拔:把硬件相关的东西从主仓收回到各自的插件里,主仓只留通用路径。这就是 Device Plugin 机制,PyTorch 这些大家熟悉的推理引擎也都支持了类似的技术。昆仑芯这边,我们做的就是 SGLang-Kunlun 这个开源插件。
有了它,主仓的代码更简洁也更好维护,主社区的开发者不用再被繁琐的后端分类困扰,可以把精力放在调度、缓存、并行这些所有硬件都受益的能力上。而各个插件自己控制发布节奏,自己保证可用性和实时集成,不再受主仓节奏牵制,也不会阻塞主仓。
落到国产芯片上,开发者只需要关心自己的平台和 ROCm、CUDA 主流生态差别在哪,通讯库 XCCL、向量计算簇与矩阵计算簇的划分,还有特定硬件的显存。社区更新了版本、或者修了个 bug,你不需要重新 rebase 一遍代码,也不用逐个 pick PR,那个过程非常冗杂。
我们之前就吃过亏:某些算子在特定设备上要先做 tensor 连续化处理,才能拿到正确的输入输出、跑出更高的算子性能。可一旦 rebase,不管是 AI 来做还是有经验的工程师来做,这种细致入微的平台经验都有可能丢掉。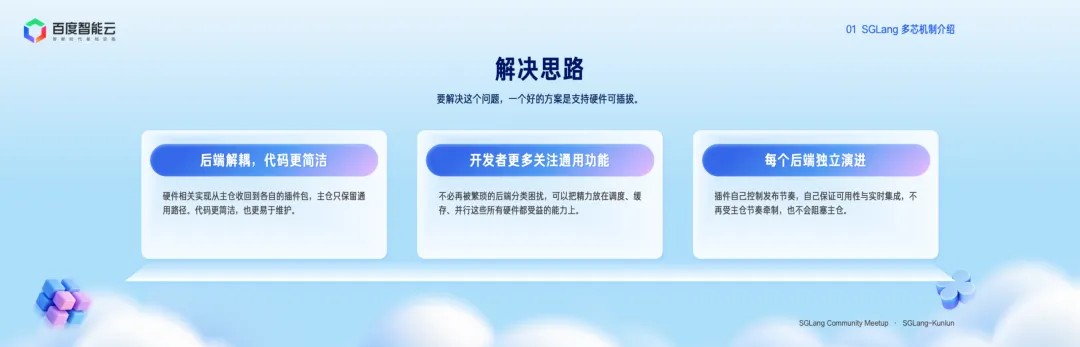
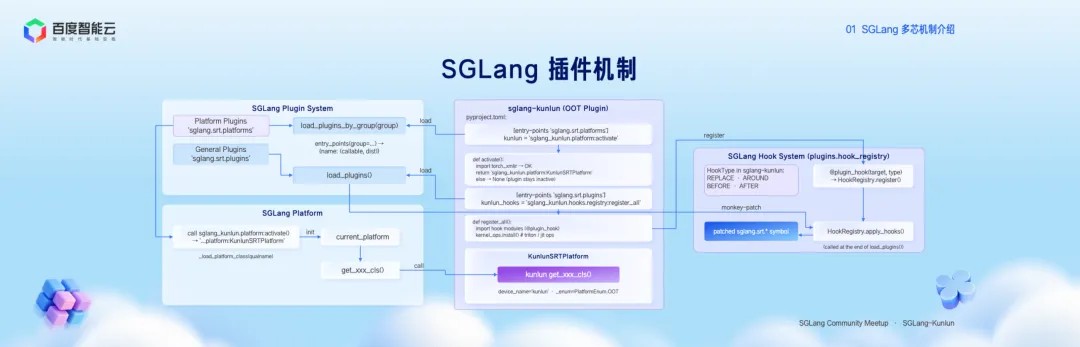
这是 SGLang 社区,加上 SGLang-Kunlun 的 out-of-tree 平台的整体架构。整体上,SGLang Plugin 分两套机制。
第一套是 Platform。昆仑平台有自己的通讯库,我们叫 XCCL,也有自己的算子后端。各平台之间,attention backend 的实现基本都是不同的,我们这边是 Kunlun AttentionBackend。做法是在社区主流架构里,对 Platform 需要替换的部分留出 hook:比如 attention 通过 get_xxx_cls 提前实例化,拿到昆仑 attention 的对象。这样做的好处是只要整套系统不发生大的变化,不管社区怎么迭代更新,你注册的 attention 算子、你的 attention layer 实现,永远是可以复用的。
第二套是 Hook。不同异构平台之间还有一些很细的东西,社区开发者没法实时关注。比如我的平台上 Triton 编译器在某些算子上编译效果不够好,是不是要做个 patch?再比如通讯库在 init 的时候要先传一小批数据,这批数据到底多少,才能让真正的推理一开始就保持高效?每个平台给的答案都不一样。所以我们设计了一套官方的 API,用装饰器的方式,把这些细致入微的平台 patch 统一起来。以前那种散乱的 monkey patch,现在都能收进这套机制。
做插件系统,我们最看重的就是尽量少改社区代码。
这里第一个关键,也是整套架构的灵魂,我们叫它 cuda-like:在 SGLang-Kunlun 这个 out-of-tree 平台里,device 内部命名是 kunlun,但当 SGLang 问「你是什么设备」的时候,我们会告诉它,我就是 cuda。这么一「伪装」,上游大量为 CUDA 写好的逻辑,比如 graph runner,就能原样复用,省掉海量重复改动。
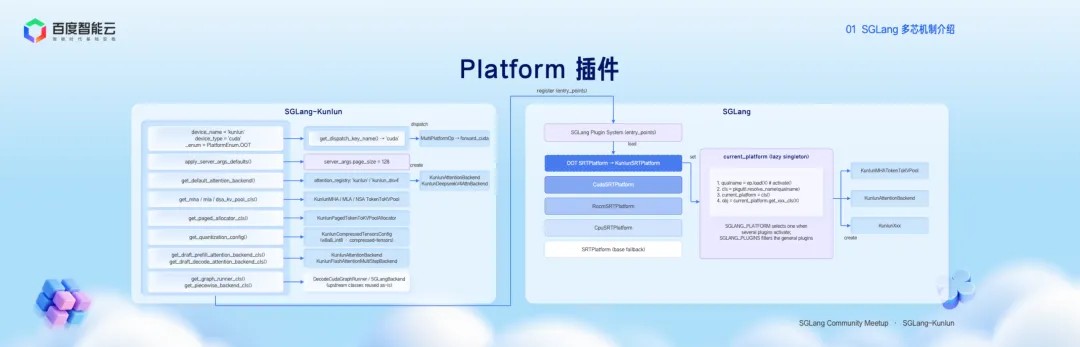
第二个关键,是用 Python 的 entry points 做即插即用。如果大家有昆仑芯的卡,使能这个平台非常简单:pip install sglang,再 pip install sglang-kunlun。
装上插件后,它会先探测环境里有没有昆仑芯,有才激活、没有就静默。具体就是只有 activate() 读到 torch_xmlir,也就是昆仑芯对应的那个 PyTorch 版本,才会注册昆仑 Platform。
激活之后,再通过 hook 把该替换的实现悄悄换成昆仑版本。多个插件同时激活时,由 SGLANG_PLATFORM 选其一。整个过程,SGLang 主仓一行代码都不用改,官方发布版直接就能用。
顺便说一句,就在昨天,9 月 21 日,SGLang-Kunlun 已经正式开源到百度百舸的开源仓库里了。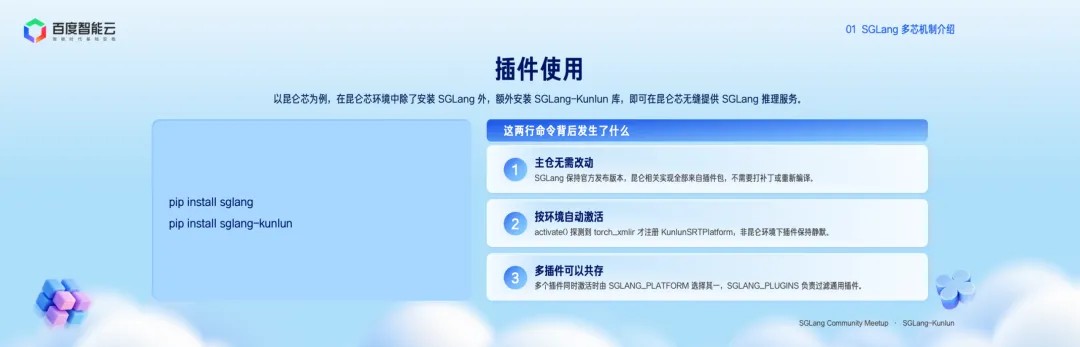
2. SGLang-Kunlun 在昆仑芯上的实践
这一页是 SGLang-Kunlun 的全栈架构。从下往上,最底层是昆仑芯 XPU,中间是高性能昆仑芯算子库和工具链,最上面才是 SGLang-Kunlun 插件,负责模型注册、attention 分发这些上层逻辑。
设计上就一个原则:硬件复杂度尽量往下压,越往上越干净。
我重点讲中间的高性能昆仑芯算子库:XSpeedgate 是我们称呼他的名字,是百度百舸开发和使能的。从 Attention Backend 到算子层都有覆盖:MLA、FLA、MSA,量化方向的 GPTQ、AWQ、Compressed Tensor,融合算子里的 Fused MoE、Fused MoE EP、SwiGLU、Split_Norm_Rope 都在里面,供大家调用。它同样开源到了社区,而且我们提供实时最新版本,大家可以拉下来,在昆仑芯上直接体验 SOTA 算子。
工具链这边是 torch_xray。它帮我们在昆仑芯上 hook 所有的 Kernel 节点,拿到每个 Kernel 的输入输出。遇到精度问题有两种模式,可以 dump 同一个模型、同一套并行策略下 GPU 或 CPU 的输出做校对。另外就是 PyTorch Profiler,主流生态的开发者都很熟悉,昆仑芯上也完整支持。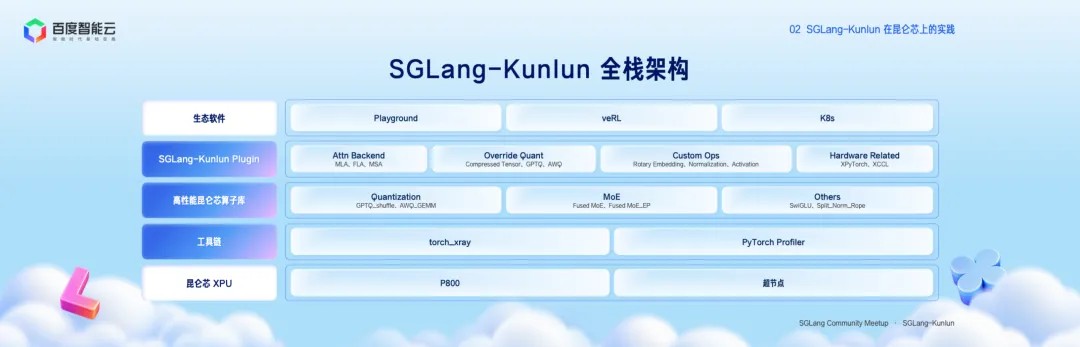
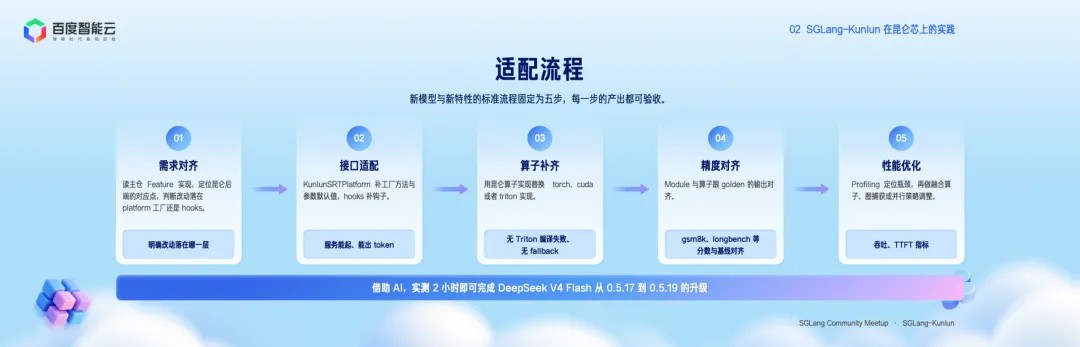
一个个模型和特性适配下来,我们沉淀出了一套标准化流程,固定五步,每一步都有硬性验收。
第一步,需求对齐:读主仓的 Feature 实现,定位昆仑后端的对应点,判断这次改动落在 Platform 工厂还是 hooks,产出是一份明确的落点判断。
第二步,接口适配:在 KunlunSRTPlatform 上补工厂方法和参数默认值,在 hooks 里补钩子,验收标准是服务能起、能出 token。
第三步,算子补齐:用昆仑算子替换 torch、CUDA 或者 triton 的实现,验收标准是没有 Triton 编译失败、没有 fallback。
第四步,精度对齐:让 module 和算子的输出跟 golden 对齐,验收标准是 gsm8k、longbench 这些分数跟基线一致。
第五步,性能优化:用 Profiling 定位瓶颈,再做融合算子、图捕获或者并行策略的调整,看吞吐和 TTFT。
正因为每一步都可验收,这套流程才敢稳稳跟上社区节奏。走完这一套你会发现,在国产卡上开发大模型确实越来越简单,在 CUDA 或者主流生态上积累的经验,七成到八成能直接迁移过来。有多快?借助后面要讲的 AI,我们实测只用了两个小时,就完成了 DeepSeek V4 Flash 从 0.5.17 到 0.5.19 的升级。
这是我们目前支持的主流模型列表,两种量化方式:W8A8 和 W4A8。DeepSeek V4 Flash 走 W8A8,激活和权重都是 8bit,吞吐优先,Prefill 用 TP+CP+EP、Decode 用 DPA+TP+EP,投机解码支持 DSpark。DeepSeek V4 Pro 走 W4A8,权重 4bit、激活 16bit,精度优先。
此外 MiMO-V2-Flash、MiniMax-M3、DeepSeek V3.2、GLM5.x 也已经支持。这些都会同步开源,Agent 场景调用比较多的最新模型基本都在列表里,后面还会持续迭代。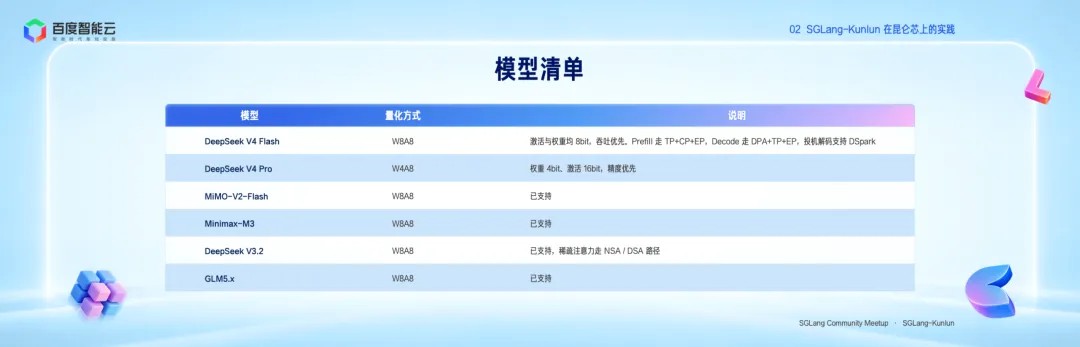
这一页是支持的能力清单。主流 CUDA 社区有的能力,昆仑芯上都做了支持,有的还不错,有的已经比较完整:PD 分离、CP / DP / PP / TP / EP / DPA 这一整套并行,MHA / GQA / SWA / MLA 以及 NSA、DSA 这类稀疏注意力,EAGLE 和 DSpark 两条投机解码路径,compress-tensor 的 W8A8 与 W4A16,还有 Hicache 的 L1 / L2 / L3 多级缓存。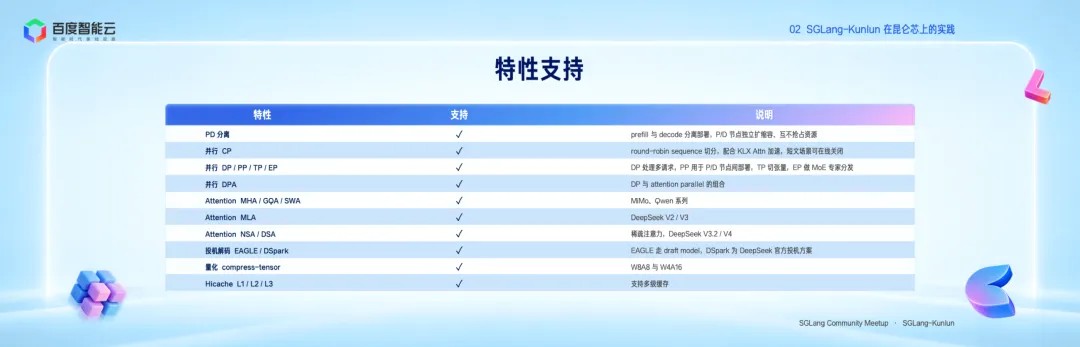
昆仑兼容 CUDA,所以 SGLang 自带的 torch profiler 在昆仑上不用改一行、直接就能用,做分析几乎没有额外成本。
我们习惯从两头看瓶颈:
CPU 侧看 worker 线程的忙等与执行周期、forward 调用栈从 Python 到 C++ 的算子下发路径、torch.compile 的 graph capture 时序,用来判断瓶颈是框架开销还是算子本身。
设备侧看算子级耗时占比、内存拷贝占比和通信占比,用来判断到底该优化算子、减少拷贝,还是调整并行策略。
从抓出来的 trace 看,在昆仑芯上用和在 CUDA 上用,观感上完全没有区别,唯一不同的是 device 上的算子,名字和实现是我们昆仑芯的版本。也就是说,你的开发经验可以直接搬过来。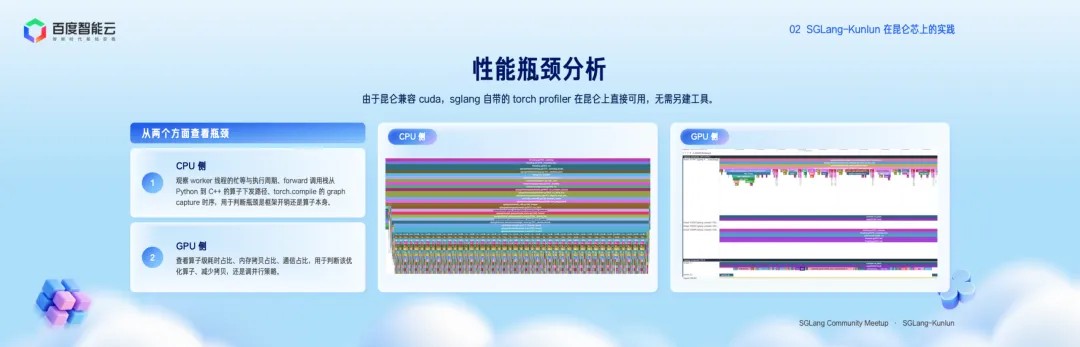
国产芯片做优化无非三个方向:算子、下发开销和通信。下面挑几个真实案例。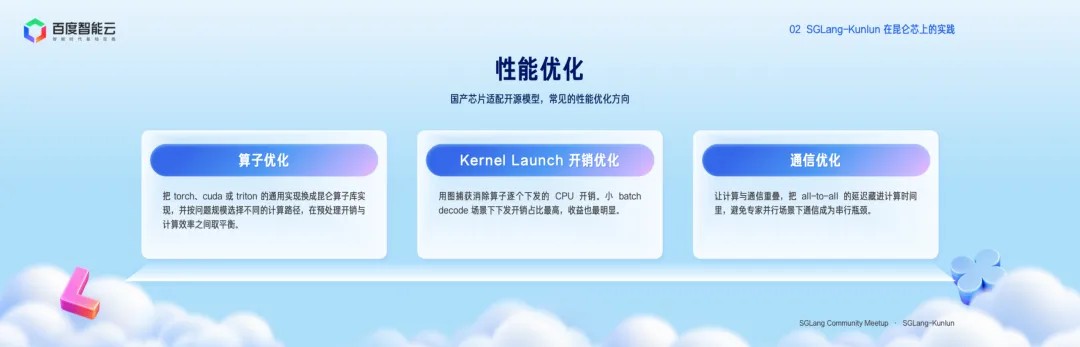
我们会把 torch、CUDA、triton 的通用实现换成昆仑算子库实现,并按问题规模选不同的计算路径。
最典型的是 DeepSeek V4 的 HCA / CSA,分别对应连续搬运的 KV cache 和稀疏搬运的 KV cache,覆盖这两套机制的全部数据场景。真实业务场景,上下文已经到了 60K,这组数据是在 M=16384 的条件下测的:HCA,也就是大家熟悉的 C128,Flash 上 MFU 31.8%、MBU 59.8%,Pro 上 MFU 45.5%、MBU 50.3%。CSA,也就是 C4,Flash 上 MFU 31.3%、MBU 58.2%,Pro 上 MFU 48.6%、MBU 46.0%。
CSA 上我们还多做了一层,借助了昆仑芯三代的一个硬件特性。向量计算簇和矩阵计算簇本身可以同时开工,于是我们用向量计算簇把稀疏 KV 搬进 L3 环形缓冲,矩阵计算簇在旁边并行地算 attention,把访存和计算叠着跑。就这一下,相比不开双流,C4 这类算子开启算子双流之后,Flash 上是 1.55 倍,Pro 上是 1.38 倍,而且这套思路对任意稀疏注意力都通用。更多算子优化也会陆续同步到 XSBackend,大家可以直接用,这个版本的算子已经在开源版本里了。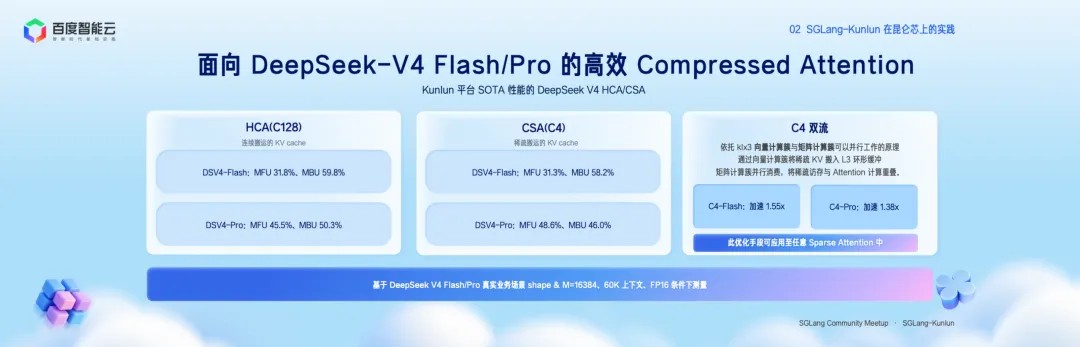
算子逐个下发的 CPU 开销,在小 batch decode 场景会直接压住吞吐,我们用 CUDA Graph 把它吃掉,一共四个动作:
一是 Piecewise 捕获,只对静态子图做 graph capture,动态部分回退 eager。
二是再叠加 Full 捕获,静态区间整段捕获,压掉剩余的下发开销。
三是同步开销优化,减少图内外的显式同步。
四是把通信算子也一并纳入图里,避免打断计算图。
昆仑芯的 device 后端就是 CUDA,所以我们要争取把 CUDA 上已经实现的优化方式全都用起来。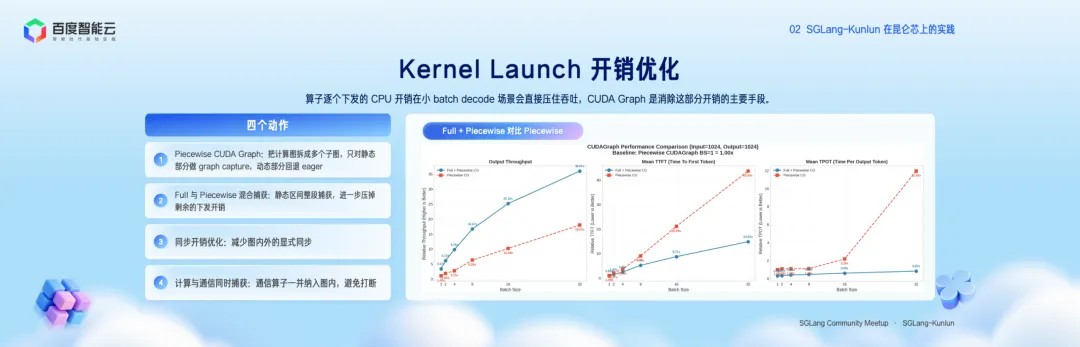
我们用 Dual-Batch Overlap 配合 DeepEP,把请求拆成两个 micro batch 交织着跑:一个在做 dispatch、combine 通信的时候,另一个正好在算 attention 和 MoE,all-to-all 的延迟就被藏进了计算里,专家并行场景下通信不再是串行瓶颈。实现原理和 CUDA 社区是同一套。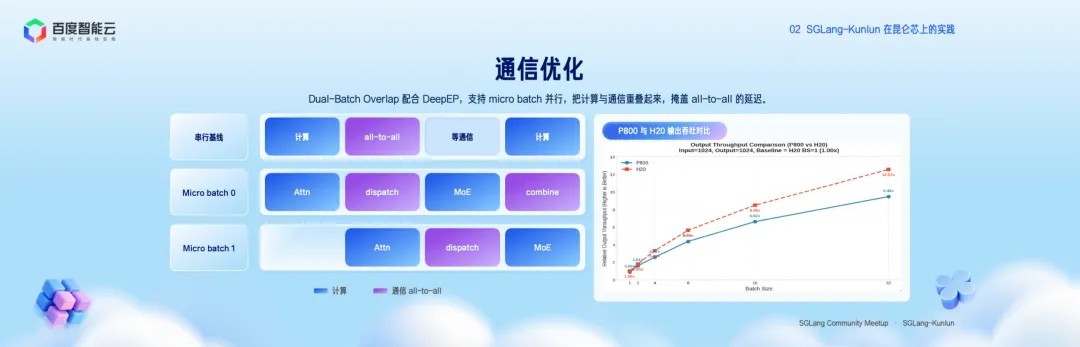
3. Plugin + Harness 效果展示
现在的模型和推理引擎已经在为 60K、500K 甚至更长的上下文做服务了。换个角度想,这么长的上下文,其实更多的也是我们这些开发者自己在用。
那能不能反过来,用 Agent 来做 Infra?
我们开发 Plugin 的时候,Agent 时代还没有完全到来。但出发点是一致的:有了 Plugin 这套系统,开发者就不用从 SGLang 上百万行源码里翻找,这个点要改,那个点要加,可能涉及四五十个文件,每个文件改一两行,学习和调试成本都很高。所以我们把所有代码放进一个单独的库,Agent 只需要聚焦 Plugin 这几个模块,避免主仓里的平台代码对它造成干扰。
很多人第一反应是,直接让 AI 去改 SGLang 主仓不就完了?我们试过,不靠谱。主仓一个特性会牵扯一大片平台、算子、调度和默认参数,AI 打个单点补丁很容易错位。框架代码也不能只看「能跑」,还得管正确性、性能和回退路径,多进程行为也得照顾。更要命的是,一次性的 patch 沉淀不下来,下次模型一升级又得从头人肉对齐。
我们的解法,是把适配经验收敛成一个足够聚焦的 Skill,再用 Harness 去驱动它。说白了,就是让 AI 只盯着插件那几个模块,按我们写好的决策规则和验证脚本干活:它负责重复的检索、草稿、批量验证和记录,而架构决策和最终验收,始终握在工程师手里。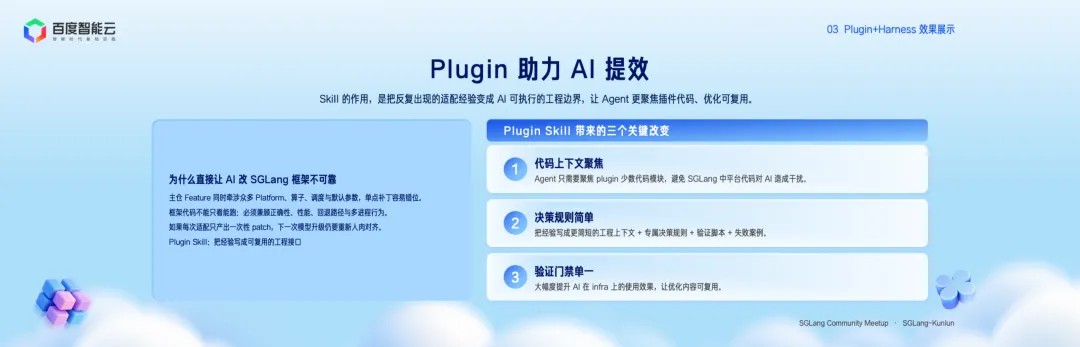
刚才那五步,我们把它交给 Harness 来驱动,形成闭环。
需求对齐这一步,AI 对比主仓 Feature、Platform 方法和昆仑适配点,生成定位报告。接口适配,AI 依据 Platform Map 生成工厂方法和默认参数,Hook 只用在目标明确的地方。算子补齐,AI 按 Operator Recipe 选择昆仑实现,并记录 fallback 和编译失败的路径。精度对齐,AI 自动组织 module 与 golden 的对比,以及 gsm8k、longbench 这些基线结果。性能优化,AI 汇总 Profiling、候选优化和回归结果,最终由工程师决定采用哪套优化组合。
每一步都有 AI 任务、人工门禁和可验收的产物。AI 承担的是重复检索、草稿生成、批量验证和记录,架构决策和验收权还是留在工程师手里。前面那个两小时升级,还有接下来要讲的、Agent 自己排出流水线切分方案并定位到那行 irecv 代码,靠的都是这套东西。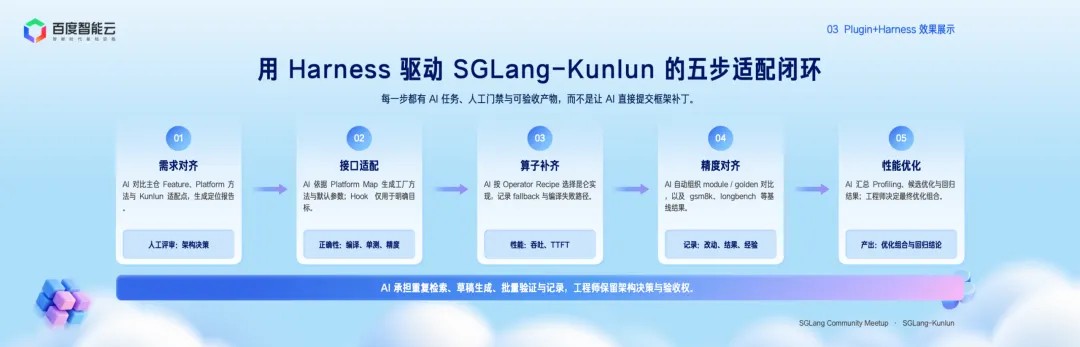
我们也用它跑了实战案例。
上下文暴涨之后,PP 成了 Prefill 节点上接近主流的并行方式,而目前社区版本的 PP 还有一些问题,我们自己在开发 PP 时也踩到过。
这个案例的场景是 DeepSeek V4 Pro、60K Prefill、TP8×PP4。基于这套分析系统,Agent 可以自动生成分析报告。这是一份中间态产物,给开发者看的。它先自动部署、跑各类 profiling,然后基于各 PP Stage 的 trace 搜索并排序层均衡方案,给出候选 16-15-16-14。接着分析 PP Bubble 的根因,从等待链里识别出 PP1 等 PP0、PP2 等 PP1、PP3 等 PP2,并提示 PP0 host 提交间隙这个假设。
这些判断都是 Agent 自主分析出来的。人其实不需要逐行读这份报告,它的价值在于给你更高的置信度,让你确认 Agent 做的事是对的。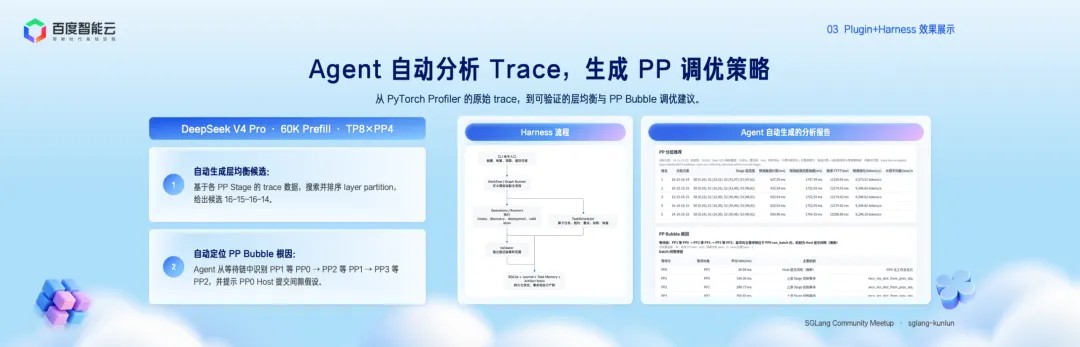
最后这个案例最能说明问题,它是从一次 AI 诊断,一直追到了具体的一行代码。
修复同样是 Agent 自己完成的。先说层均衡,它能找到最优方案。另一个例子:原本 irecv A 和 irecv B 是非阻塞通讯,但 wait A 和 wait B 是阻塞行为,于是每个 stage 之间都要走一遍 irecv A → wait A → irecv B → wait B 来传元信息。本来想并行接收,却写成了收完 A 再收 B,异步全白搭。
顺着这个线索去查代码,Agent 给出了修改方案:先把所有接收一次性投递出去,再统一等待,一次性把 A 和 B 的 tensor 位置都创建好,多路接收这才真正并行起来,之后才进下一个流程。这一处改动,端到端实测提升了 10% 左右。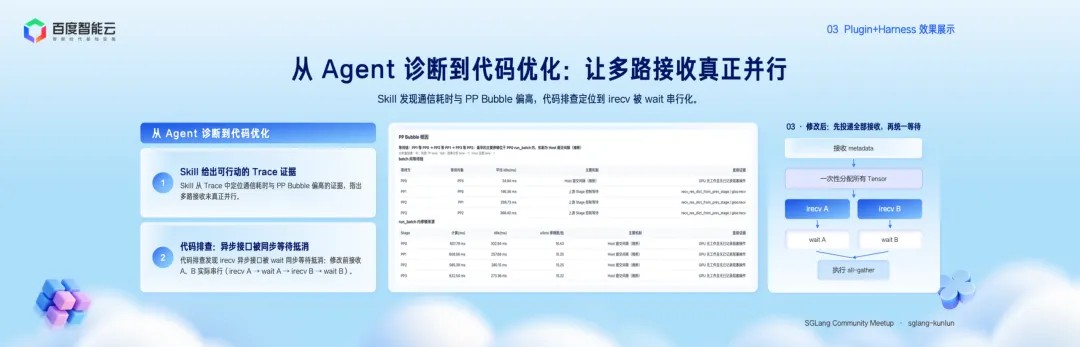
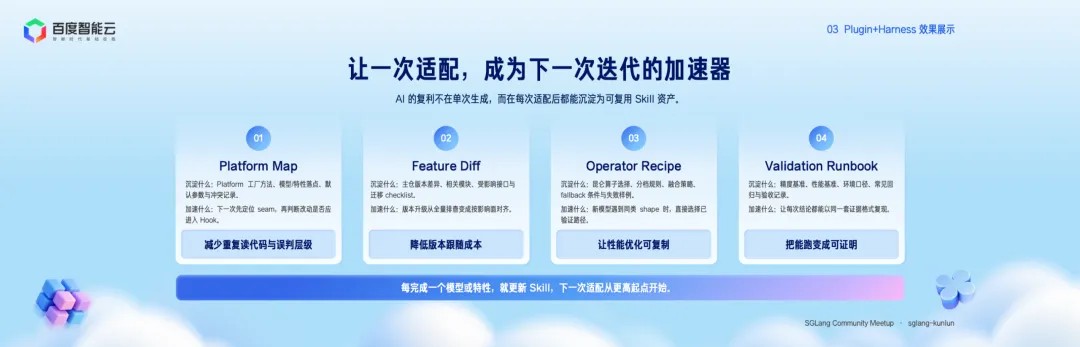
所以我们觉得,Plugin 配合 Agent,相当于有四步升级:
第一,减少重复读代码和误判层级,沉淀出 Platform Map,把工厂方法、模型特性落点、默认参数和冲突记录留下来。
第二,降低版本跟随成本,沉淀 Feature Diff,把主仓版本差异、相关模块、受影响接口和迁移 checklist 留下来。
第三,让性能优化可复制,沉淀 Operator Recipe,把昆仑算子选择、分档规则、融合策略、fallback 条件和失败样例留下来。
第四,把能跑变成可证明,沉淀 Validation Runbook,用同一套精度基准、性能基准、环境口径和验收记录来复现结论。
更关键的是,每完成一个模型或者一个特性就更新一次 Skill,下一次适配直接从更高的起点开始。让一次适配,成为下一次迭代的加速器,这才是我们真正想要的。
最后介绍一下百度百舸的 Loong 系列开源体系。
除了 SGLang-Kunlun,仓库下面目前还有另外 4 个项目:
LoongForge 做统一的全模态训练框架,覆盖 LLM、VLM、diffusion 和具身模型等。
LoongSage 做面向前沿大模型的生产级 Agentic RL。
LoongFlow 做 Harness,是一个能从自身运行中学习的 agent 框架。
LU-KV 做 KV Cache 的长程效用优化。
从训练、强化到 Harness、再到 KV 优化迭代,全链路都在这里了。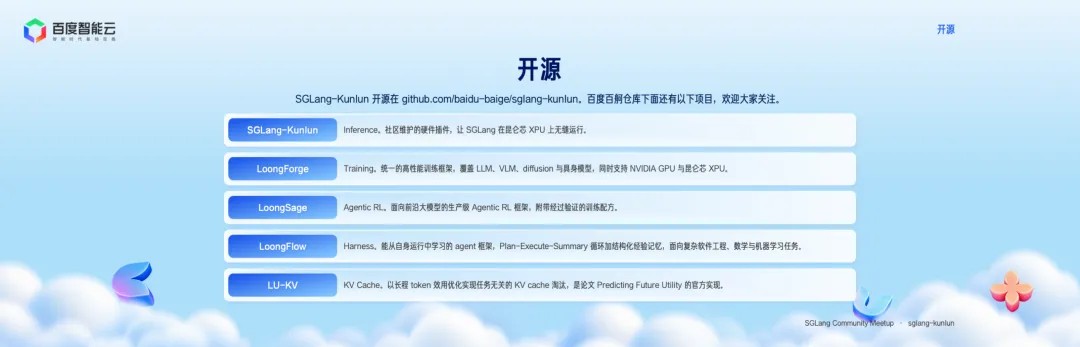
今天我的分享就到这里,谢谢大家。
相关文章推荐
发表评论
关于作者

- 被阅读数
- 被赞数
- 被收藏数
登录后可评论,请前往 登录 或 注册